Strata oder Colibrì: Große KI-Modelle lokal im Vergleich 2026
Strata 0.2.10 und Colibrì 2.1.0 im Vergleich: Modelle, Hardware, Tempo und Datenschutz für große KI-Modelle auf dem eigenen PC, mit Entscheidungshilfe und FAQ. Stand 5. November 2026.
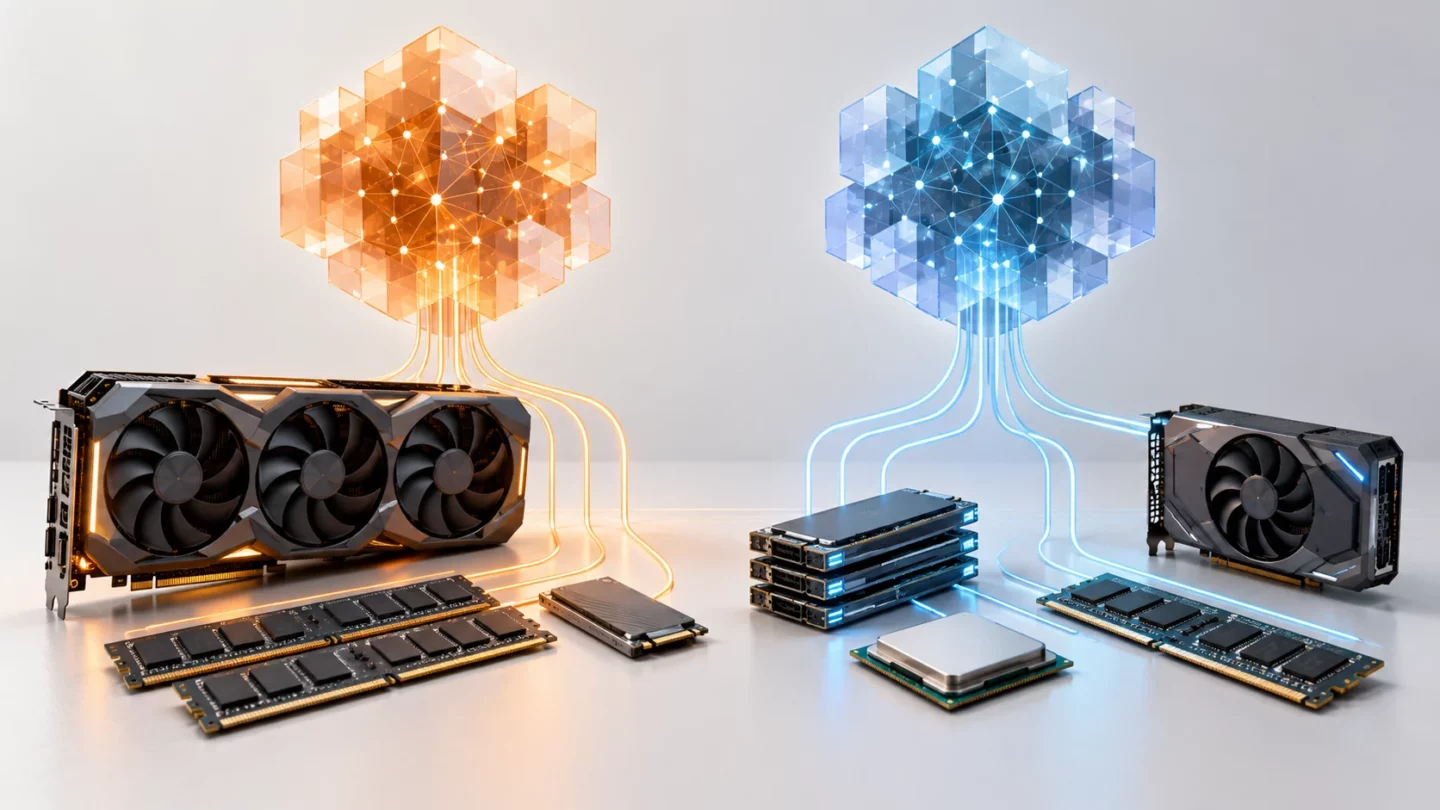
Strata und Colibrì bringen große KI-Modelle auf einen normalen PC, indem sie das Modell auf Grafikkarte, Arbeitsspeicher und SSD verteilen. Strata ist die geführte Lösung mit Desktop-App, vor allem für Qwen und DeepSeek. Colibrì ist die vielseitigere Engine mit mehr als einem Dutzend Modellfamilien und läuft auch ganz ohne Grafikkarte. Dieser Vergleich ist auf dem Stand vom 5. November 2026: Strata 0.2.10 und Colibrì 2.1.0.
Das Wichtigste in Kürze
- Gemeinsame Idee: Bei Mixture-of-Experts-Modellen ist pro Token nur ein kleiner Teil des Modells aktiv. Beide Programme legen häufig gebrauchte Teile in schnellen Speicher und holen den Rest bei Bedarf von der SSD.
- Strata passt, wenn du Qwen3.8-Flash-Next oder DeepSeek V4.1 Flash mit möglichst wenig Handarbeit nutzen willst: Installer, Desktop-App, Hardwaremonitor und Anbindung an Coding-Werkzeuge.
- Colibrì passt, wenn du verschiedene Modellfamilien ausprobieren, ohne separate Grafikkarte arbeiten oder veröffentlichte GGUF-Dateien direkt nutzen willst. Es ist in C geschrieben, die Einrichtung läuft über ein Python-Skript.
- Aktualisiert: Die erste Fassung nannte bei Strata nur Qwen. Inzwischen ist klar, dass auch DeepSeek V4.1 Flash dazugehört, seit Version 0.2.7.1 auch auf dem Mac und der NVIDIA DGX Spark. Colibrì liest seit 2.1.0 GGUF-Dateien nativ und hat eine neue Chat-Oberfläche.
- Tempo: Es gibt keinen belastbaren Sieger. Die Projekte messen auf unterschiedlicher Hardware mit unterschiedlichen Modellpaketen. Wir haben selbst nichts gemessen.
- Beide sind Open Source (Strata: MIT, Colibrì: Apache 2.0). Die Lizenz der Modelle gilt getrennt davon.
Inhalt:
- Was sich seit dem ersten Vergleich geändert hat
- Das gemeinsame Prinzip
- Die wichtigsten Unterschiede im Überblick
- Strata im Detail
- Colibrì im Detail
- Wie schnell sind die beiden wirklich?
- Welche Hardware brauche ich?
- Schnittstellen, Datenschutz und Sicherheit
- Entscheidungshilfe: Was passt zu wem?
- Häufige Fragen
- Quellen und Stand
Was sich seit dem ersten Vergleich geändert hat
Die erste Fassung dieses Beitrags erschien am 26. Oktober 2026. Seitdem sind beide Projekte stark weiterentwickelt worden. Strata hat zwischen dem 25. Oktober und dem 2. November fünf Versionen veröffentlicht (0.2.6 bis 0.2.10), Colibrì ist am 31. Oktober von Version 2.0 auf 2.1.0 gesprungen. Das ändert einige Aussagen der ersten Fassung:
| Thema | Erste Fassung (Recherche 22. Oktober) | Stand 5. November 2026 |
|---|---|---|
| Strata: Modelle | Nur Qwen3.8-Flash-Next und Qwen3.6-35B-A3B genannt | Auch DeepSeek V4.1 Flash (191 bis 274 GB Download, je nach Paket), in App und Terminal |
| Strata: Systeme | Unterstützte GPUs und Apple Silicon | Seit 0.2.7.1 zusätzlich NVIDIA DGX Spark (Linux ARM64, nur Terminal) und DeepSeek auf dem Mac; AMD Ryzen AI Max (Strix Halo) hat eine eigene Anleitung |
| Colibrì: Dateiformate | Eigener Container, Umwandlung nötig | GGUF-Dateien laufen nativ (coli import), ohne Umwandlung und ohne zweite Quantisierung |
| Colibrì: Modelle | Qwen, GLM, DeepSeek, Kimi | Zusätzlich Mistral-Large-4 (1 Billion Parameter), Muse Spark Open, Flint und LFM3-VL; insgesamt 13 Engines |
| Colibrì: Oberfläche | Dashboard im Browser genannt | Neue Chat-Oberfläche mit Expertenkarte; bis zu 16 Gespräche gleichzeitig |
| Colibrì: Kontext | Nicht erwähnt | Laut Projekt 256k Kontext bei Qwen3.8-Flash-Next ungefähr im Tempo von 64k (auf einer CUDA-Testmaschine) |
Das gemeinsame Prinzip: Das Modell muss nicht komplett in den Grafikspeicher
Viele aktuelle große Modelle arbeiten mit Mixture of Experts (MoE). Das Modell besteht aus sehr vielen spezialisierten Teilnetzen, den Experten. Pro Token wählt ein Router nur wenige davon aus. Bei GLM-5.2 mit 744 Milliarden Parametern sind das laut Colibrì-Dokumentation etwa 40 Milliarden pro Token, und davon wechselt von einem Token zum nächsten nur ein kleiner Teil.
Daraus folgt der Trick, den beide Projekte nutzen: Das Modell muss nicht komplett im schnellen Speicher liegen, es muss nur sinnvoll platziert werden. Häufig genutzte Experten bleiben auf der Grafikkarte oder im RAM, selten genutzte werden bei Bedarf von der SSD nachgeladen.
- Strata beschreibt in HOW_IT_WORKS eine Aufteilung auf Grafikkarte, RAM und SSD. Die GPU hält die häufig genutzten Experten, weitere liegen im RAM, eine Nachschlagetabelle bleibt auf der SSD.
- Colibrì hält die dichten Teile (Attention, geteilte Experten) im RAM, die Routing-Experten auf dem Datenträger und dazwischen einen lernenden Cache. Eine GPU, falls vorhanden, bekommt die „heißesten“ Experten.
Der Preis ist bei beiden derselbe: Je mehr vom Modell auf die SSD ausweichen muss, desto langsamer wird die Antwort. Bei sehr großen Modellen bestimmt dann die Datenträgergeschwindigkeit das Tempo, nicht die Grafikkarte. Eine ausführliche Erklärung am Beispiel Strata liefert unser Grundlagenbeitrag zu Strata.
Die wichtigsten Unterschiede im Überblick
| Bereich | Strata 0.2.10 | Colibrì 2.1.0 |
|---|---|---|
| Ausrichtung | Geführte Komplettlösung rund um wenige Modelle | Offene Engine für viele Modellfamilien, auch als Forschungsplattform |
| Modelle | Qwen3.8-Flash-Next, Qwen3.6-35B-A3B, DeepSeek V4.1 Flash | Qwen3.6/3.8, GLM-5.2/5.3, DeepSeek V4/V4.1, Kimi K3, MiMo, Mistral-Large-4, Inkling, OLMoE u. a.; dazu Bildmodell Qwen-Image-2.1 |
| Einstieg | Installer für Windows, Linux und Mac; Desktop-App mit Chat und Hardwaremonitor; alternativ strata launch im Terminal | ZIP herunterladen und START-HERE.bat starten (Windows) bzw. ./start-here.sh (Linux, macOS); danach Browser-Dashboard |
| GPU nötig? | Ja, unterstützte Grafikkarte oder Apple Silicon | Nein, jede Engine läuft auch rein auf der CPU |
| GPU-Backends | NVIDIA (CUDA), AMD (HIP), Intel Arc (SYCL, Linux), Apple (Metal) | Vulkan (AMD, Intel, NVIDIA, auch integrierte GPUs), CUDA, Metal |
| Modellformate | Vorbereitete Pakete (ISTA-DASLab, Unsloth u. a.) | Eigener Container und veröffentlichte GGUF-Dateien, unverändert gelesen |
| Schnittstellen | OpenAI- und Anthropic-kompatible API auf localhost | OpenAI- und Anthropic-kompatible API, Tool Calling, Bilder und Dokumente als Eingabe (modellabhängig) |
| Lizenz (Programmcode) | MIT | Apache 2.0 |
Die breite Modellauswahl sagt nichts darüber aus, wie gut ein einzelnes Modell für deine Aufgabe ist. Und: Wenn beide Programme dasselbe Modell anbieten, etwa Qwen3.8-Flash-Next, sind die Pakete oft nicht identisch. Strata empfiehlt vorbereitete Pakete von ISTA-DASLab, Colibrì arbeitet laut Dokumentation mit dem offiziellen FP8-Modell oder mit GGUF-Dateien.
Strata im Detail: klarer Einstieg, mehr Hardware-Auswahl
Strata richtet sich an alle, die ein großes Modell lokal nutzen wollen, ohne sich in Einstellungen zu verlieren. Die Desktop-App lädt beim ersten Start die Engine für die vorhandene Grafikkarte herunter, bietet Chat, Dateien und eine Live-Vorschau für Code in einem Fenster und überwacht Temperatur, Tempo und Speicher.
Welche Modelle laufen?
- Qwen3.8-Flash-Next ist der Schwerpunkt. Die empfohlenen ISTA-DASLab-Pakete brauchen laut Modellübersicht zwischen 37,6 GB (Q2_0, am schnellsten) und 54,8 GB (IQ3_S, beste Qualität) an RAM plus VRAM. Dazu kommen Unsloth-Pakete mit 4 bis 8 Bit sowie eine Coder-Variante für Programmieraufgaben.
- Qwen3.6-35B-A3B ist das kleinere Modell für Rechner mit weniger Speicher (laut Projekt 32 bis 52 GB RAM).
- DeepSeek V4.1 Flash ist seit Ende Oktober dabei. Es braucht laut Projekt eine Grafikkarte ab 12 GB, 46 bis 64 GB RAM und 245 bis 280 GB freien Plattenplatz, weil vieles von der SSD gelesen wird.
Welche Systeme werden unterstützt?
Dokumentiert sind NVIDIA GeForce RTX 20 bis 50, AMD Radeon RX 7000/9000 und Radeon AI PRO R9700, Intel Arc (Linux), Apple Silicon ab M1 mit macOS 15, AMD Ryzen AI Max (Strix Halo) und die NVIDIA DGX Spark. Radeon RX 6800/6900 gelten als experimentell. Intel-Macs werden nicht unterstützt. DeepSeek V4.1 Flash läuft nicht auf jeder dieser Plattformen, die Liste steht in der Modelldokumentation.
Wie viel eine Karte mit 12 GB wirklich leistet, hängt vom Arbeitsspeicher und der SSD ab. Die Grafikkarte allein ist keine vollständige Systembeschreibung. Mit dem Befehl strata launch --plan zeigt Strata, was fehlt, bevor etwas heruntergeladen wird.
Colibrì im Detail: breite Modellauswahl, auch ohne Grafikkarte
Colibrì (im Repository colibri geschrieben) wirbt mit dem Satz „Tiny engine, immense model“. Der Rechenkern ist in C geschrieben, pro Modellfamilie gibt es eine eigene Engine. Das Setup-Skript prüft RAM, freien Plattenplatz, CPU und GPU, empfiehlt ein passendes Modell, baut oder lädt die Engine, lädt das Modell mit Fortsetzungsfunktion herunter und öffnet am Ende das Dashboard im Browser. Dafür ist Python nötig; unter Windows bietet das Skript die Installation an.
Mindestanforderungen und Modelle
Laut Projekt genügen mindestens 8 GB RAM und 22 GB freier Plattenplatz für das kleinste Modell. Die wichtigsten Stufen aus der Modelltabelle:
| Modell | Download | RAM (Start / wie gemessen) | Gemessen vom Projekt |
|---|---|---|---|
| Qwen3.6-35B-A3B | 23 GB | 10 / 20 GB | 6,0 Token/s auf der CPU, 30,0 mit CUDA (RTX 3070 8 GB) |
| Qwen3.8-Flash-Next | 186 GB | 24 / 32 GB | 1,9 bis 2,6 Token/s auf der CPU, 4,0 mit optionalen int4-Experten |
| DeepSeek V4 Flash (284B) | 167 GB | 16 / 32 GB | 0,93 Token/s (CPU, 32 GB RAM); 1,5 bis 1,6 mit CUDA (RTX 5080) |
| GLM-5.2 (744B) | 429 GB | 16 / 24 GB | 1,83 Token/s auf einem Ryzen AI Max+ 395 mit 128 GB |
| Kimi K3 (2,8 Billionen) | 1,56 TB | 32 / 64 GB | etwa 9,4 Sekunden pro Token |
Das Beispiel Kimi K3 zeigt, wo die Grenze liegt: Das Modell läuft auf einem Rechner mit 32 GB RAM, aber nicht in einer Geschwindigkeit, die sich zum Chatten eignet. Colibrì macht große Modelle zugänglich, nicht automatisch schnell.
GGUF und neue Modelle
Seit Version 2.1.0 liest Colibrì veröffentlichte GGUF-Dateien, zum Beispiel von Unsloth, direkt ein. Mit coli import entsteht ein Modellordner, die Blöcke bleiben so, wie die Datei sie enthält (von IQ1_S bis Q8_0, F16, BF16 und MXFP4). Das spart die Umwandlung und erlaubt Modelle, die sonst nicht in Frage kämen, etwa Mistral-Large-4 mit einer Billion Parametern in einer 233-GB-Variante.
Wie schnell sind die beiden wirklich?
Einen Sieger nennen wir nicht. Ein fairer Vergleich bräuchte denselben Rechner, dasselbe Modell, gleichwertige Gewichte und dieselben Aufgaben. Die veröffentlichten Messungen unterscheiden sich in all diesen Punkten. Zur Orientierung hier, was jedes Projekt für sich angibt:
Strata (Messungen des Projekts)
| Modell und Hardware | Antwort-Tempo | Quelle |
|---|---|---|
| DeepSeek V4.1 Flash, 2,00 bpw, RTX 3060 12 GB, 46 GB RAM | 9 bis 11 Token/s | README |
| DeepSeek V4.1 Flash, 2,00 bpw, RTX 5070 12 GB, 64 GB RAM | 4 bis 6 Token/s | README |
| DeepSeek V4.1 Flash, 2,25 bpw, Ryzen AI Max (Strix Halo), Windows | etwa 12 Token/s | Release 0.2.9 |
| Qwen3.8-Flash-Next IQ3_S, Ryzen AI Max (Strix Halo), Windows | etwa 59 Token/s | Release 0.2.9 |
Colibrì (Messungen des Projekts)
| Modell und Hardware | Antwort-Tempo | Quelle |
|---|---|---|
| Qwen3.6-35B-A3B (GGUF UD-Q4_K_M), i5-13500, RTX PRO 4000 Blackwell 24 GB | 104,8 Token/s (CUDA), 92,9 (Vulkan), 13,9 (CPU) | Benchmarks |
| Qwen3.8-Flash-Next IQ2_XS (68 GB), gleiche Maschine | 51,4 Token/s (CUDA), 50,6 (Vulkan), 9,3 (CPU) | Benchmarks |
| DeepSeek V4.1 Flash UD-IQ1_S, gleiche Maschine, Vulkan | 5,0 bis 5,3 Token/s | Benchmarks |
| GLM-5.2 UD-IQ1_S (202 GB), gleiche Maschine, Vulkan | 0,63 bis 0,66 Token/s | Benchmarks |
Was sich daraus lernen lässt: Sobald ein Modell größer ist als RAM und VRAM zusammen, fällt das Tempo stark, bei beiden Programmen. Zwischen Qwen3.8-Flash-Next auf einer guten Grafikkarte und einem Billionen-Modell vom Datenträger liegen mehrere Größenordnungen. Die Zahlen beider Tabellen stammen von verschiedenen Rechnern und lassen sich nicht gegeneinander aufrechnen.
Für die eigene Entscheidung zählen drei Dinge: die Wartezeit bis zum ersten Token, das Tempo der weiteren Antwort und die Qualität bei der eigenen Aufgabe. Strata bringt dafür den Befehl strata bench run mit, Colibrì ein Benchmark-Protokoll in der Dokumentation. Beide Projekte weisen darauf hin, dass Datenträger und Cache-Zustand die Ergebnisse stark beeinflussen.
Welche Hardware brauche ich?
| Dein Rechner | Sinnvoller Einstieg | Erwartung |
|---|---|---|
| Weniger als 16 GB RAM, keine dedizierte GPU | Colibrì mit kleinem Modell (OLMoE ab 8 GB; Qwen3.6-35B-A3B startet laut Projekt ab 10 GB, 20 GB sind für den gemessenen Betrieb angegeben) | Eher für Experimente; 8 GB sind die Untergrenze des Setups |
| 32 GB RAM, Grafikkarte mit 8 bis 12 GB | Strata mit Qwen3.6-35B-A3B oder Qwen3.8 Coder; Colibrì mit Qwen3.6-35B-A3B | Brauchbares Tempo bei kleinen Paketen; große Modelle werden langsam |
| 64 GB RAM, Grafikkarte ab 12 GB, schnelle NVMe-SSD | Strata mit Qwen3.8-Flash-Next (IQ2_XS bis IQ3_S) oder DeepSeek V4.1 Flash | Die Zielklasse beider Projekte; DeepSeek braucht über 245 GB freien Platz |
| Mac mit Apple Silicon und viel Unified Memory | Strata (Mac-App); DeepSeek ab 64 GB nur Text | Colibrì hat ein Metal-Backend, das Setup baut aber standardmäßig für die CPU |
| Ryzen AI Max (Strix Halo) mit 128 GB | Strata oder Colibrì | Beide haben eigene Anleitungen und Messwerte für diese Plattform |
| Mehrere Grafikkarten, viel RAM | Colibrì für Billionen-Modelle, Strata für Qwen und DeepSeek | Strata nutzt unter Linux jetzt auch mehrere Karten für ein Modell |
Der Plattenplatz wird oft unterschätzt. Die Strata-Pakete für Qwen3.8-Flash-Next brauchen 37,6 bis 54,8 GB an RAM und VRAM, das offizielle Modell, das Colibrì laut Dokumentation lädt, belegt rund 186 GB auf dem Datenträger. Beide Zahlen messen Verschiedenes und sind nicht direkt vergleichbar. DeepSeek V4.1 Flash braucht je nach Paket 191 bis 274 GB. Plane zusätzlich Platz für Hilfsdateien und Modellvorbereitung ein.
Schnittstellen, Datenschutz und Sicherheit
Beide Programme starten einen lokalen Server mit OpenAI- und Anthropic-kompatiblen Schnittstellen. Damit lassen sich Coding-Werkzeuge wie Claude Code, Codex CLI oder OpenCode auf das lokale Modell umleiten. Bei Strata zeigt strata connect die passende Einrichtung, bei Colibrì genügen Basis-URL http://127.0.0.1:8000/v1 und ein beliebiger nicht leerer Schlüssel. Colibrì kann bis zu 16 Gespräche gleichzeitig bedienen.
„Kompatibel“ heißt nicht, dass alle Funktionen entfernter Dienste nachgebaut sind. Colibrì nennt in der API-Dokumentation unterstützte Endpunkte und Einschränkungen, zum Beispiel hat ein übergebener seed-Wert keine Wirkung. Werkzeugaufrufe und Bildeingaben hängen vom jeweiligen Modell ab.
- Strata sendet nach eigener Aussage keine Nutzungsdaten, Absturzberichte oder Analysen und braucht kein Konto. Der Server lauscht nur auf
127.0.0.1, also auf dem eigenen Rechner. Websuche und das Öffnen von Webseiten durch den Coding-Agenten verlangen eine Bestätigung pro Chat (SAFETY). - Colibrì läuft ebenfalls lokal. Wer den Server im Netzwerk erreichbar macht, sollte Zugangsschutz und Konfiguration bewusst prüfen. Die Dokumentation nennt dafür die Optionen von
coli serve. - Lokal ist nicht automatisch abgeschottet: Angeschlossene Programme, Websuche oder externe Modelldienste können weiterhin Verbindungen nach außen aufbauen.
Entscheidungshilfe: Was passt zu wem?
| Wenn du … | Dann eher … | Warum |
|---|---|---|
| lokal mit Qwen3.8-Flash-Next arbeiten und eine fertige App haben willst | Strata | Installer, Chat, Hardwaremonitor und empfohlene Pakete |
| DeepSeek V4.1 Flash auf einer 12-GB-Karte testen willst | Strata | Dokumentierte Messwerte für RTX 3060 und 5070, geführte Einrichtung |
| kein Interesse an Terminal-Befehlen hast | Strata | Die Desktop-App deckt Download, Auswahl und Chat ab |
| ohne Grafikkarte oder mit integrierter GPU arbeiten willst | Colibrì | CPU-Betrieb und Vulkan für beliebige GPUs sind vorgesehen |
| mehrere Modellfamilien (GLM, Kimi, Mistral, MiMo) ausprobieren willst | Colibrì | Breiteste Modellauswahl, GGUF direkt nutzbar |
| am Verfahren selbst interessiert bist, etwa an der Expertenverteilung | Colibrì | Dashboard mit Expertenkarte, offene Messprotokolle |
| ein Programm für Coding-Werkzeuge im Dauerbetrieb suchst | Beide testen | Beide bieten OpenAI- und Anthropic-Schnittstellen; die Stabilität hängt vom Modell ab |
Der sinnvollste Weg ist in beiden Fällen derselbe: erst ein Modell wählen, das zum eigenen Speicher passt, und es mit einer überschaubaren Testaufgabe prüfen. Erst danach lohnt sich der Download der ganz großen Pakete.
Lizenzen: Der Programmcode von Strata steht unter MIT-Lizenz, der von Colibrì unter Apache 2.0. Die Modelle haben eigene Lizenzen, die vor allem bei kommerzieller Nutzung zu prüfen sind. Zum Beispiel steht Qwen-Image-2.1 in Colibrì unter einer nichtkommerziellen Lizenz, und Muse Spark Open hat eine eigene Lizenzvereinbarung von Meta.
Einen allgemeinen Überblick, wie lokale Sprachmodelle auf Mac, Windows und AMD laufen, gibt unser Ratgeber LLM lokal installieren.
Häufige Fragen
Was ist der Unterschied zwischen Strata und Colibrì?
Strata ist eine geführte Komplettlösung mit Desktop-App für wenige Modelle, vor allem Qwen3.8-Flash-Next und DeepSeek V4.1 Flash. Colibrì ist eine offene Engine für mehr als ein Dutzend Modellfamilien, die auch ohne Grafikkarte läuft. Beide verteilen große Mixture-of-Experts-Modelle auf GPU, RAM und SSD.
Kann ich ein großes KI-Modell ohne Grafikkarte betreiben?
Mit Colibrì ja: Jede Engine läuft laut Projekt auch rein auf der CPU. Das Tempo hängt dann von RAM und SSD ab und liegt bei großen Modellen oft unter einem Token pro Sekunde. Strata setzt eine unterstützte Grafikkarte oder Apple Silicon voraus.
Wie viel Arbeitsspeicher brauche ich für Qwen3.8-Flash-Next?
Bei Strata benötigen die empfohlenen Pakete zwischen 37,6 GB (Q2_0) und 54,8 GB (IQ3_S) an RAM plus VRAM. Colibrì nennt für das offizielle Paket 24 GB RAM zum Start und 32 GB für den gemessenen Betrieb, bei rund 186 GB Download. Die Werte sind Projektangaben und hängen von Kontext und Einstellungen ab.
Welches Programm ist schneller?
Das lässt sich nicht pauschal sagen. Die Projekte messen auf verschiedener Hardware mit unterschiedlichen Modellpaketen. Wir haben keinen eigenen Vergleich unter gleichen Bedingungen durchgeführt. Entscheidend sind Hardware, Modellgröße und Quantisierung.
Sind Strata und Colibrì kostenlos?
Ja, beide Programme sind Open Source (Strata: MIT-Lizenz, Colibrì: Apache 2.0) und kosten nichts. Die Modelle haben eigene Lizenzen, die für den kommerziellen Einsatz geprüft werden sollten.
Bleiben meine Eingaben auf meinem Rechner?
Die Modellberechnung findet lokal statt. Strata gibt an, keine Nutzungsdaten zu senden, und lauscht nur auf 127.0.0.1. Verbindungen nach außen entstehen, wenn du Websuche, externe Modelldienste oder andere Programme anbindest.
Kann ich Claude Code oder andere Coding-Werkzeuge anbinden?
Ja. Beide stellen OpenAI- und Anthropic-kompatible Schnittstellen auf dem lokalen Rechner bereit. Bei Strata zeigt strata connect die Einrichtung, bei Colibrì trägst du die lokale Basis-URL ein. Welche Funktionen wie Werkzeugaufrufe funktionieren, hängt vom Modell ab.
Quellen und Stand
Recherchestand: 5. November 2026 (erste Fassung: 22. Oktober 2026). Grundlage sind die offiziellen Repositories und Dokumentationen: Strata (Release 0.2.10 vom 2. November 2026) und Colibrì (Release 2.1.0 vom 31. Oktober 2026). Beschriebene Unterstützung, Anforderungen und Messwerte sind Projektangaben; unsere Einordnung ist als solche gekennzeichnet. Es handelt sich um einen dokumentationsbasierten Vergleich ohne eigenen Leistungstest. Das Beitragsbild ist eine KI-generierte Symbolillustration und zeigt keine verbindliche Hardwarekonfiguration.
- Strata: Releases und Änderungsnotizen (0.2.6 bis 0.2.10)
- Strata: Modelle und Speicherbedarf
- Strata: Installation und unterstützte Systeme
- Strata: Funktionsweise
- Strata: Datenschutz und Sicherheit
- Strata: Community-Benchmarks
- Colibrì: Releases (2.0.0 und 2.1.0)
- Colibrì: Quickstart
- Colibrì: Benchmarks
- Colibrì: GGUF-Unterstützung
- Colibrì: API-Dokumentation
- Colibrì: Qwen3.8-Flash-Next
Kommentare
Noch keine Kommentare. Schreiben Sie den ersten.